DeepSeek系列模型落地昇腾生态
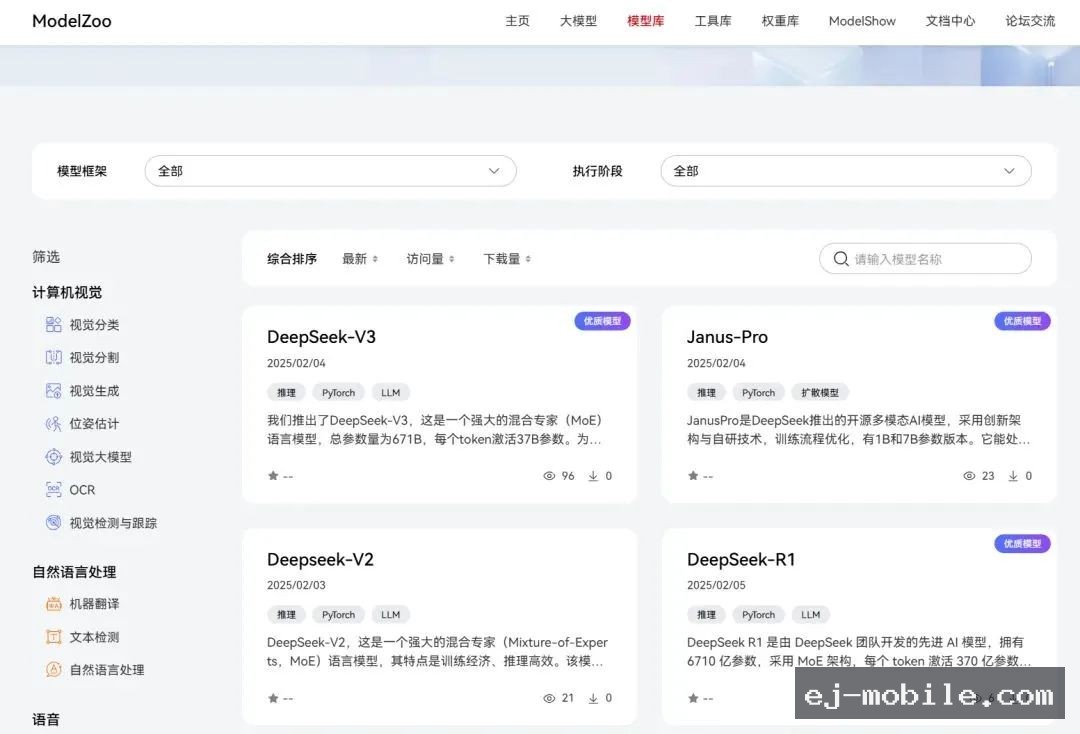
DeepSeek AI近期发布的多模态大模型Janus-Pro,以及此前推出的大型语言模型DeepSeek-R1、DeepSeek-V3与DeepSeek-V2,自发布以来便在AI领域引发广泛关注,多项创新技术显著提升了模型的性能与效率。DeepSeek系列模型已首发支持昇腾平台,J9官方直营推理服务器产品搭载昇腾硬件,可全面支持DeepSeek系列模型的快速部署,为用户带来更快、更高效、更便捷的AI开发和应用体验。2025年2月4日,DeepSeek-R1、DeepSeek-V3、DeepSeek-V2及Janus-Pro正式上线昇腾社区,支持一键获取模型,并在昇腾硬件平台上实现开箱即用,进一步降低了开发者的使用门槛。
部署环境与硬件配置要求
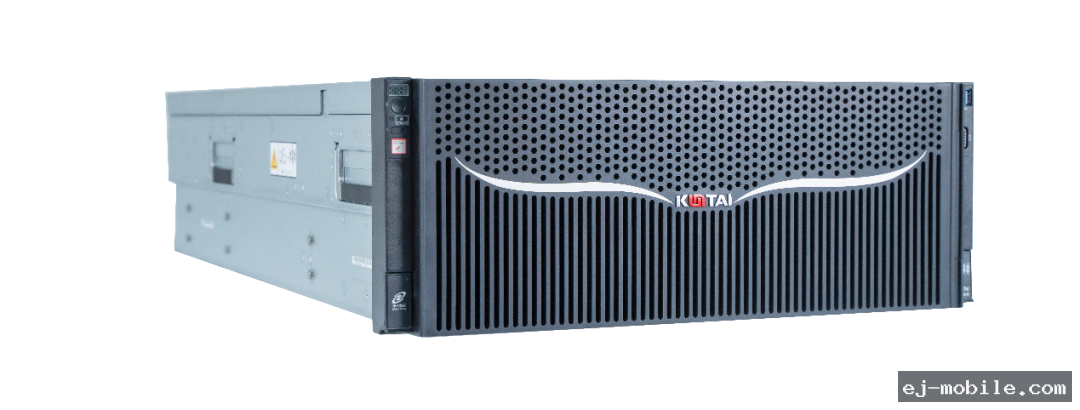
以DeepSeek-V3模型的部署为例,要实现高效推理,需配置4台该公司KunTai A924推理服务器,每台服务器搭载8张昇腾推理卡,以满足模型对算力和内存的高要求。部署前,需在昇腾社区的开发资源专区下载适配DeepSeek-V3的镜像包,具体镜像名称为mindie:1.0.T71-800I-A2-py311-ubuntu22.04-arm64。下载完成后,可通过docker images命令确认镜像名称与标签,确保环境就绪。该公司推理服务器在此架构下,能提供稳定且高性能的算力支撑。
模型获取与容器化启动
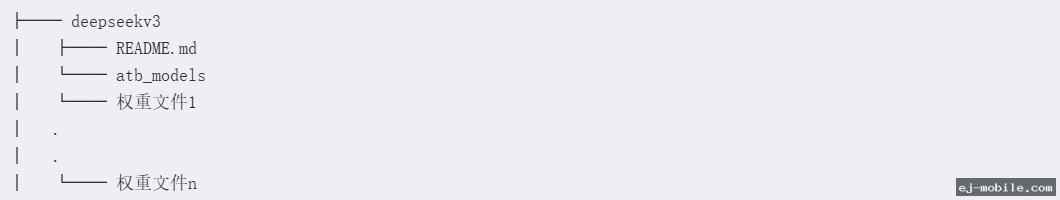
昇腾社区提供的MindIE镜像已预置DeepSeek-V3模型推理脚本,简化了部署流程。开发者需从可信来源自行获取模型权重,并将其放置在已下载的模型代码主目录下。为确保权限正确,需将模型文件夹的属组修改为1001,并将执行权限设置为750。完成上述步骤后,即可启动容器,整个过程体现了该公司服务器与昇腾生态的深度适配,大幅缩减了模型上线时间。
服务配置与运行状态验证
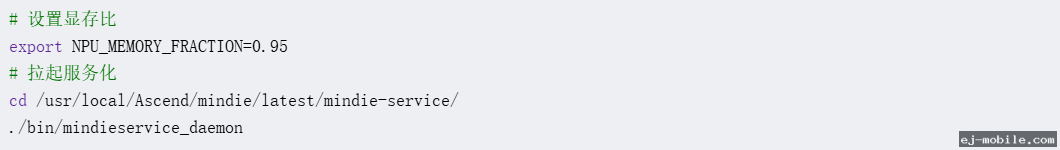
容器启动后,需配置服务化环境变量,例如开启expandable_segments功能,使能内存池扩展段特性,即虚拟内存特性,以优化推理过程中的内存分配。配置完成后,若图片显示“Daemon start success!”,则表明服务已成功启动。这一状态提示为开发者提供了明确的部署完成信号,确保该公司推理服务器上的服务处于可正常提供推理服务的状态。
持续学习与生态资源获取
为更深入了解DeepSeek系列模型在昇腾平台上的使用方法及指导文档,开发者可登录昇腾社区模型库专区进行学习。社区提供了丰富的资源,包括DeepSeek-R1、DeepSeek-V3等模型的详细获取链接和使用指南,有助于开发者快速掌握模型部署与优化技巧,充分发挥J9官方直营推理服务器的性能优势,加速AI应用落地。